
مدفوعةً باستراتيجية «AI+» الصينية والسياسات الداعمة للتحول الرقمي والذكي في قطاع الطاقة، تعمل صناعة النفط والغاز على تسريع انتقالها من العمليات القائمة على الخبرة إلى الذكاء القائم على البيانات. وقد أدى الاستخدام المتزايد للذكاء الاصطناعي في تفسير قراءات الآبار، والتنبؤ بالمكامن، والإنذار المبكر بحوادث الحفر، إلى جعل مجموعات البيانات عالية الجودة عنصرًا أساسيًّا للتغلب على العوائق التي تعترض طريق التنمية الذكية. ولا تزال هناك ثلاثة تحديات رئيسية: عدم الاتساق بين البيانات والأعمال، حيث تتوزع البيانات الجيولوجية والجيوفيزيائية والإنتاجية غير المتجانسة عبر عشرات الأنظمة دون دلالات مشتركة أو آليات للمشاركة؛ عدم وضوح حدود التعاون بين النماذج الكبيرة والنماذج الصغيرة المتخصصة، حيث تفتقر النماذج الكبيرة ذات الأغراض العامة إلى الفهم العميق لمجال البترول، بينما تظل النماذج الصغيرة معزولة مع إعادة استخدام محدودة للبيانات؛ وعدم كفاءة عملية التوضيح، حيث لا يمكن للتصنيف اليدوي التقليدي تلبية احتياجات تدريب النماذج الصغيرة وضبط النماذج الكبيرة.
محرر النصوص: النص
تتناول هذه الدراسة دورة حياة الاستكشاف والتطوير بأكملها، وتحدد ثلاث فئات من مجموعات البيانات عالية الجودة: دعم الأعمال، وتدريب النماذج الصغيرة، وضبط النماذج الكبيرة. ويوضح هذا التصنيف حدود تطبيقها ومعايير البيانات ومسارات التنفيذ. وتركز هذه المقاربة على نمذجة أنطولوجيا الأعمال خماسية الأبعاد، وتتكامل مع بنية OSDU المفتوحة، حيث تقسم سير عمل قطاع النفط والغاز إلى أكثر من 40,000 عقدة أعمال دنيا، وتبني أنطولوجيا تشمل مجالات الكائنات والأعمال والعمل والتخصص والعمليات التجارية. يتم دمج البيانات التجارية والمعايير وحالات المعرفة والقواعد التجارية في رسم بياني شامل للمعرفة التجارية يوفر هيكلاً دلالياً مشتركاً. ومن ثم، تدعم حوكمة البيانات وهندسة الميزات واستخراج المعرفة البناء المعياري لجميع فئات مجموعات البيانات الثلاث، مما يعالج مشكلة عزل البيانات والمعايير غير المتسقة والتعليقات التوضيحية غير الفعالة. ويدعم الأساس الناتج إدارة الإنتاج والنمذجة الذكية وتحسين اتخاذ القرار، مما يطور الحوكمة من تنقية البيانات إلى إدارة البيانات الدلالية والموجهة للكائنات والقائمة على المعرفة.
تتبع كل فئة مسارًا تقنيًّا متميزًا. تستخدم مجموعات البيانات الداعمة للأعمال حوكمة شاملة — من الاستيعاب من مصادر متعددة، إلى التنقية والإصلاح، والتوحيد القياسي، وفحص الجودة الآلي — لضمان اكتمال البيانات واتساقها مع متطلبات الأعمال. تستخدم مجموعات البيانات الخاصة بتدريب النماذج الصغيرة مخزن ميزات مؤسسي لمواءمة مستوى التفصيل عبر الزمن والعمق والطبقات الجيولوجية، مع استخدام الرسوم البيانية المعرفية لدعم التصنيف الآلي للميزات. أما مجموعات البيانات الخاصة بضبط النماذج الكبيرة، فتستخدم 15 نوعًا من قوالب الأسئلة والأجوبة، بما في ذلك التعريفات والإجراءات والعلاقة السببية، إلى جانب معاجين دلالية شاملة في مجال البترول لتوليد أزواج منظمة من الأسئلة والأجوبة.
الكلمات المفتاحية: مجموعات البيانات عالية الجودة؛ نمذجة أصل الأعمال خماسي الأبعاد؛ العقدة التشغيلية الدنيا؛ خريطة المعرفة؛ الذكاء الاصطناعي؛ حوكمة البيانات؛ OSDU؛ المعجم الدلالي؛ أزواج الأسئلة والأجوبة.
في ظل التوجيهات السياساتية، تعمل صناعة النفط والغاز — التي تُعد ركيزة أساسية لأمن الطاقة — على تسريع تحولها من العمليات القائمة على الخبرة إلى الاستخبارات القائمة على البيانات. وتشهد التطبيقات التي تجمع بين الذكاء الاصطناعي وأعمال الاستكشاف والتطوير والإنتاج والعمليات توسعاً متزايداً، مما يجعل القدرات الذكية محركاً رئيسياً لتطور الصناعة بجودة عالية.
تُعد البيانات مدخلاً إنتاجياً أساسياً لهذا التحول، وتؤثر جودتها بشكل مباشر على تدريب النماذج والقيمة التجارية. ومع تزايد اعتماد الذكاء الاصطناعي، أصبحت كل من النماذج الصغيرة المتخصصة في التفسير الآلي لسجلات الآبار والتنبؤ بالمكامن، والنماذج الكبيرة المستخدمة في القطاع والتي تغطي مجالات عمل متعددة، تتطلب بيانات أكثر دقة واكتمالاً واتساقاً وذات صلة بالأعمال. وتشكل مجموعات البيانات عالية الجودة أساساً للتدريب الدقيق، وتربط بين سير العمل التجاري والتكنولوجي، وتتيح التعاون بين الأقسام المختلفة، وتدعم عملية اتخاذ القرار الذكي ذات الحلقة المغلقة.
ومع ذلك، لا يزال هناك تحديان رئيسيان. الأول هو التناسق بين البيانات والأعمال: فسلسلة القيمة الطويلة والعمليات المعقدة تؤدي إلى تشتت البيانات عبر مصادر متعددة دون دلالات مشتركة أو حوكمة موحدة، مما يؤدي إلى ظهور «صوامع» البيانات وفصلها عن سير العمل التجاري. أما التحدي الثاني فهو عدم وضوح المكانة التي تحتلها النماذج الكبيرة والصغيرة: فالنماذج الكبيرة ذات الأغراض العامة تفتقر إلى الفهم العميق للمجال، بينما تظل النماذج الصغيرة المتخصصة معزولة، كما تفتقر أنظمة النماذج إلى حلقة تغذية مرتدة مغلقة مع بيانات العالم الواقعي. لذلك، فإن بناء مجموعات بيانات مصممة خصيصًا لتطبيقات مختلفة، ووضع عمليات موحدة لإنشائها وإدارتها، أمران ضروريان للتغلب على هذه العوائق.
تضع هذه الدراسة إطارًا تصنيفيًّا منهجيًّا لمجموعات البيانات عالية الجودة التي تلبي الاحتياجات الأساسية للتطوير الذكي في قطاع النفط والغاز، حيث تحدد مجالات التطبيق ومتطلبات البيانات والمعايير التقنية. ومن خلال دراسة أساليب الإنشاء والتقنيات الرئيسية لثلاث فئات من مجموعات البيانات، تطور الدراسة حلاً شاملاً يركز على أنطولوجيا الأعمال خماسية الأبعاد، مدعومةً برسوم بيانية معرفية ومحميةً بحوكمة البيانات، لمعالجة عدم الاتساق في التوافق مع متطلبات الأعمال، والتباينات بين النماذج والبيانات، والتمثيل غير القياسي للمعرفة.
الهدف النهائي هو إنشاء إطار عمل قابل للنشر والتوسع يعمل على توحيد إدارة البيانات التجارية، ويتيح إعادة الاستخدام الفعال لبيانات النمذجة، ويقوم بتنظيم بيانات المعرفة. وهو يدعم التشغيل المستقر لأنظمة الأعمال اليومية، والتدريب الدقيق للنماذج الصغيرة، وتكييف النماذج الكبيرة مع المجال المعني، مما ينقل التطوير الذكي من مرحلة الاستكشاف التقني إلى مرحلة التطبيق التجاري الأعمق، ويوفر أساسًا للتحول الذكي عبر سلسلة القيمة.
تقترح الدراسة إطارًا متكاملًا يتألف من جزء أساسي وثلاثة فروع داعمة. وتُعد «علم الوجود» الخماسي الأبعاد لقطاع النفط والغاز الأساس المركزي لرسم بياني موحد للمعرفة التجارية وإطار إدارة يدعم البناء المعياري لجميع فئات مجموعات البيانات الثلاث (الشكل 1).
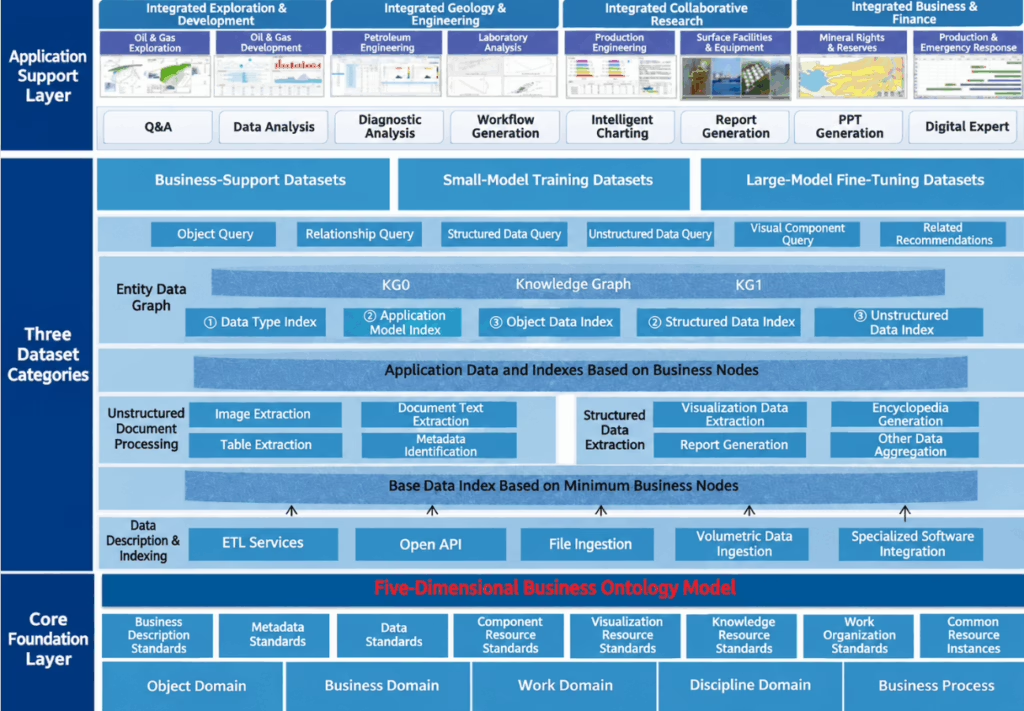
الشكل 1. الإطار العام لإنشاء مجموعات بيانات عالية الجودة في مجال النفط والغاز
تجمع الطبقة التأسيسية بين نمذجة الأعمال خماسية الأبعاد ومعايير الهندسة المفتوحة OSDU. وتغطي أنطولوجيتها مجالات الكائنات، والأعمال، والعمل، والتخصصات، والعمليات التجارية، حيث تقسم مراحل الاستكشاف والتطوير والإنتاج إلى ما يزيد عن 40,000 «عقدة أعمال» كحد أدنى. وتحدد كل عقدة بيانات الإدخال، وسير عمل المعالجة، والمخرجات، والعلاقات. ويعمل مخطط المعرفة التجارية الشامل على دمج البيانات التجارية والمعايير وحالات المعرفة والقواعد التجارية وخوارزميات المكونات في بنية أساسية دلالية مشتركة ومنصة لإدارة البيانات، مما يوفر دعمًا موحدًا للبيانات والعلاقات لجميع الفئات الثلاث.
وتستند طبقة مجموعات البيانات إلى هذا الأساس لتلبية احتياجات التطبيقات المختلفة. تمنح مجموعات البيانات الداعمة للأعمال الأولوية للاكتمال والاتساق التجاري في الأنظمة اليومية. أما مجموعات البيانات المخصصة لتدريب النماذج الصغيرة، فتركز على السمات المعيارية القابلة لإعادة الاستخدام لمهام النمذجة المتخصصة. وتُركز مجموعات البيانات المخصصة لضبط النماذج الكبيرة على المعرفة الصناعية المنظمة والدقة الدلالية.
توفر طبقة دعم التطبيقات خدمات ذكية أساسية من خلال واجهات خدمات البيانات، حيث تربط مجموعات البيانات بأنظمة الأعمال والنماذج الصغيرة والنماذج الكبيرة، بهدف إرساء إدارة ذات حلقة مغلقة تشمل البيانات والنماذج والعمليات التجارية.
1. مجموعات بيانات تجارية عالية الجودة للتطبيقات التجارية اليومية
(1) سيناريوهات التطبيق
تشكل مجموعات البيانات هذه الأساس الذي تستند إليه أنظمة المعلومات المؤسسية، وتُستخدم في إدارة الإنتاج الروتينية، وتقييم الاحتياطيات، وتشغيل المعدات وصيانتها، وتدقيق الامتثال. كما أنها تدعم أنظمة تخطيط موارد المؤسسات (ERP)، وأنظمة إدارة التشغيل (MES)، وأنظمة التحكم في العمليات (PCS)، وإدارة الاحتياطيات، وغيرها من المنصات التجارية. وتكمن قيمتها الأساسية في التشغيل المستقر والتنسيق الفعال، مما يوفر بيانات موثوقة ودقيقة لاتخاذ القرارات اليومية، مثل إعداد تقارير إنتاج البئر الواحد، وتخطيط صيانة المعدات، والتقييم الديناميكي للاحتياطيات.
(2) المتطلبات الأساسية للبيانات
تغطية شاملة: تشمل دورة حياة الأعمال بالكامل والموارد مثل البيانات الأساسية (معرّفات الآبار، والكتل، ورموز المعدات)، والبيانات المعاملاتية (سجلات الإنتاج والضغط والتشغيل)، والبيانات المرجعية (رموز الصخور وأنواع السوائل)، والمعايير، وحالات المعرفة، وقواعد العمل.
الإدارة المتسقة: الفصل التام بين أوصاف الأعمال ومكان التخزين المادي، مع ربطهما عبر البيانات الوصفية للحفاظ على المرونة وقابلية التوسع.
البيانات الوصفية الكاملة: تسجيل مصدر البيانات، ووقت جمعها، ونوعها، ومتطلبات دقتها، ومعناها من الناحية التجارية، والعلاقات بينها. يجب أن تدعم البيانات الوصفية إمكانية تتبع دورة حياة الكيانات التجارية، والتحديد الدقيق للعلاقات التجارية.
الامتثال لمعايير الجودة: تطبيق حوكمة شاملة لتلبية ستة أبعاد أساسية — الدقة، والاكتمال، والاتساق، والتفرد، والتوقيت المناسب، وإمكانية التتبع — دون وجود سجلات خاطئة، أو تنسيقات متضاربة، أو غموض دلالي.
(3) مسار التنفيذ
الاستيعاب الموحد: وضع بروتوكولات مشتركة للاستيعاب من مصادر متعددة استنادًا إلى البنية المفتوحة لـ OSDU ومعايير نمذجة الأعمال الخاصة بـ OiO. دعم قواعد البيانات المنظمة، والوثائق غير المنظمة، والمنحنيات الزمنية، والصور، ومقاطع الفيديو، باستخدام تحويل التنسيقات والتعيين الدلالي لتوحيد البيانات الواردة من الأنظمة المختلفة.
الحوكمة الشاملة: إنشاء مسار عمل يشمل الاستيعاب – التنقية – التوحيد – الفحص – الأرشفة باستخدام أدوات آلية. الجمع بين محركات القواعد والتعلم الآلي لمعالجة القيم المفقودة والشاذة والمكررة. توحيد المصطلحات وقواعد الترميز والوحدات والتنسيقات. إنشاء قواعد فحص آلية تغطي جميع أبعاد الجودة الستة، باستخدام محرك القواعد Drools لفحص أصول البيانات بشكل دوري وإنتاج قوائم بالمشكلات وتوصيات لإصلاحها.
إطار عمل البيانات الوصفية: وضع بيانات وصفية تجارية وتقنية وإدارية، مدعومة بأدوات للجمع التلقائي، والإدخال اليدوي، وتحديد العلاقات، وإدارة الإصدارات. استخدام البيانات الوصفية لتتبع دورة الحياة وتحديد العلاقات التجارية.
التخزين والخدمات: دمج «بحيرة البيانات» مع «مستودع البيانات»، بحيث يتم تخزين البيانات المنظمة في المستودع، بينما تُخزَّن البيانات غير المنظمة والبيانات المتسلسلة زمنيًّا في «بحيرة البيانات». وتوفر الواجهات الموحدة خدمات الاستعلام والاسترجاع والخدمات الإحصائية مع وصول آمن وخاضع للرقابة وفعال.
2. مجموعات بيانات عالية الجودة لنمذجة البيانات الضخمة باستخدام نماذج صغيرة
(1) سيناريوهات التطبيق
تربط مجموعات البيانات هذه بين البيانات التجارية الأولية ونماذج الذكاء الاصطناعي الصغيرة المتخصصة. وتدعم مجموعات البيانات المخصصة لمهام محددة التفسير الآلي لسجلات الآبار، والتنبؤ بالمكامن، والإنذار المبكر بحوادث الحفر، والتنبؤ بالإنتاج، وتحسين عمليات الحقن والإنتاج. وتساهم السمات المعيارية وذات الصلة في تقليل وقت الإعداد الطويل، وتجنب عدم اتساق السمات، وخفض تكاليف التصنيف المرتفعة، مما يؤدي إلى تحسين كفاءة التدريب ودقة التنبؤ.
(2) المتطلبات الأساسية للبيانات
أساس الرسم البياني الموحد: استخلاص البيانات من خلال الرسم البياني الشامل للمعرفة الخاصة بقطاع النفط والغاز، للحفاظ على صلة البيانات بالأعمال والاتساق الدلالي، وتجنب التعميم الضعيف الناجم عن انعزال البيانات في «صوامع».
التفصيل المعياري: مواءمة البيانات من أنواع وتخصصات مختلفة مع وحدات قياس مشتركة عبر الزمن (الأيام، الأشهر، السنوات)، والعمق (الأمتار، الديسيمترات، الآفاق الطبقية)، والأحداث (أنواع الحوادث والعمليات)، والشبكات (الشبكات الأفقية والرأسية) لتمكين التكامل.
السمات والتصنيفات: استخراج السمات المهمة مثل المسامية، والنفاذية، ومحتوى الصخر الزيتي من خلال هندسة السمات، وتصنيفها تلقائيًا باستخدام مخطط المعرفة والحالات السابقة. إنتاج بيانات منظمة للسمات والتصنيفات متوافقة مع مدخلات التعلم الآلي.
إمكانية إعادة الاستخدام: إدارة الميزات مركزيًّا لإعادة استخدامها عبر النماذج المختلفة، مما يتيح تجنب تكرار الأعمال الهندسية والنتائج غير المتسقة مع الحفاظ على تعريفات الحسابات المشتركة.
(3) مسار التنفيذ
استخراج السمات وتوحيدها: تحديد السمات الأساسية للنمذجة من خلال مخطط المعرفة، وتطوير أدوات متخصصة تدعم المتوسطات المتحركة، وتحويلات فورييه، وإحصاءات الكميات، وتجميع الفترات. تحويل البيانات التجارية الأولية إلى سمات موحدة، باستخدام إعادة أخذ العينات بأقرب جار، والاستيفاء الخطي، وطريقة كريجينغ لمواءمة دقة التفاصيل من مصادر متعددة.
التصنيف الآلي للميزات: استخدم العلاقات في الرسم البياني وقواعد العمل لإجراء التصنيف التلقائي. وفي الحالات المعقدة، اجمع بين التصنيف الآلي ومراجعة الخبراء: حيث تُنتج الارتباطات بين البيانات الوصفية للأعمال ومطابقة الأحداث التاريخية تصنيفات أولية، يقوم خبراء المجال بالتحقق من صحتها وتصحيحها لتقليل الجهد اليدوي.
مخزن السمات: إنشاء «مركز السمات» (Feature Hub) على مستوى المؤسسة من أجل تسجيل السمات وتخزينها وإدارتها وإعادة استخدامها. تخصيص معرّف فريد لكل سمة وتسجيل اسمها ووصفها ومنطق حسابها ومصدرها والسيناريوهات التي تنطبق عليها وإصدارها. دعم عمليات البحث باستخدام الكلمات المفتاحية والسيناريوهات التجارية ومصادر البيانات من أجل الوصول السريع إلى السمات.
إنشاء مجموعات البيانات ديناميكيًا: يتيح محرك استرجاع السمات القائم على الرسوم البيانية للمستخدمين اختيار السمات ومستوى التفصيل اللازمين لمهمة النمذجة. ويقوم النظام بربط السمات ذات الصلة وتجميعها في مجموعات بيانات التدريب، مع دعم عمليات التصفية والفرز وحسابات التجميع والتصدير إلى تنسيقات متوافقة مع TensorFlow وPyTorch.
تقييم جودة مجموعة البيانات: تقييم كل من السمات الفردية ومجموعاتها. ويشمل تقييم السمات الدقة والاستقرار وكشف التسرب. وتُستخدم مصفوفات الارتباط وتحليل SHAP والتحقق المتبادل لتقييم العلاقات مع المتغيرات المستهدفة والتكرار بين السمات، وذلك لتحديد مدى ملاءمة النمذجة.
3. مجموعات بيانات عالية الجودة تتضمن معارف صناعية من أجل ضبط نماذج اللغة الضخمة الخاصة بقطاع النفط والغاز
(1) سيناريوهات التطبيق
تعمل مجموعات البيانات هذه على تنظيم المعرفة في مجال البترول من أجل الضبط الدقيق القابل للتكيف مع المجال، مما يحسّن الفهم والاستدلال في السياقات المتخصصة. وتشمل التطبيقات الأسئلة والأجوبة المهنية، والاستشارات المتعلقة بسير العمل، وتفسير المعايير، وإنشاء تقارير البحث آليًّا، وإنشاء الرسوم البيانية المستندة إلى اللغة الطبيعية. ومن الأمثلة على ذلك الاستشارات المتعلقة بالاستجابة لحوادث الحفر، ومخططات تقارير تقييم الاحتياطيات، والتصور الذكي للبيانات بناءً على طلبات باللغة الطبيعية، مما يحسّن الكفاءة ويقلل من الجهد اللازم لاكتساب المعرفة في هذا المجال.
(2) المتطلبات الأساسية للبيانات
تغطية معرفية شاملة: استخدم الرسم البياني المعرفي الشامل للأعمال لتضمين البيانات التجارية والمعايير وحالات المعرفة وقواعد الأعمال وخوارزميات المكونات، بما يصف دورة الحياة الكاملة للاستكشاف والتطوير.
الهيكل الموحَّد: تنظيم البيانات من خلال نظام مصطلحات موحد يحدد «العقد التجارية» وأنواع الكيانات وأنواع العلاقات، لضمان تمثيل معرفي متسق ومنطقي، وتحليل فعال للنموذج.
مجموعات الأسئلة والأجوبة الغنية: تتضمن أسئلة وأجوبة شاملة منظمة أو شبه منظمة تغطي 15 نوعًا من الأسئلة، بما في ذلك التعريفات، والعلاقة السببية، والإجراءات، والمقارنات، لتوفير مدخلات متنوعة للضبط الدقيق.
معاجم دلالية كاملة: توفير المصطلحات الخاصة بقطاع النفط، والمرادفات، والاختصارات، والمصطلحات المتخصصة في هذا المجال، من أجل ربط اللغة الطبيعية بدقة بمصادر البيانات المرتبطة بـ«عقد الأعمال».
(3) مسار التنفيذ
بناء مخطط معرفي شامل: استخدام أنطولوجيا الأعمال الخماسية الأبعاد لنمذجة الكيانات الجيولوجية، والآبار، والمعدات، والعمليات، والمعايير، والمشكلات، والمؤشرات، مع علاقات مثل «ينتمي إلى»، و«يقع في»، و«يتسبب في»، و«يحل». الجمع بين البناء اليدوي والاستخراج القائم على معالجة اللغة الطبيعية (NLP) من الوثائق الفنية والمعايير والحالات التاريخية، مع دمج الكيانات والعلاقات التي خضعت لمراجعة الخبراء لضمان الدقة والاكتمال.
إنشاء أسئلة وأجوبة موحدة: تصميم 15 نوعًا من القوالب القائمة على الرسوم البيانية، بما في ذلك التعريفات («ما هو خزان الحجر الرملي منخفض النفاذية؟») والإجراءات («ما هي إجراءات التعامل مع انحشار الأنبوب أثناء الحفر؟») والعلاقة السببية («ما هي الأسباب الرئيسية لفقدان الدوران؟»). إنشاء أزواج من الأسئلة والأجوبة على دفعات باستخدام تقنية توليد اللغة الطبيعية (NLG)، مع استكمالها بأسئلة وأجوبة مستخرجة من الأوراق البحثية وأدلة التشغيل، بالإضافة إلى أزواج عالية الجودة تمت صياغتها يدويًّا.
المعجم الدلالي للصناعة: تجميع أكثر من 30,000 مصطلح أساسي مع تعريفاتها ومرادفاتها واختصاراتها وسياقات استخدامها. ربط المصطلحات بكيانات الرسم البياني المعرفي حتى تتمكن النماذج من تحديد الموارد التجارية ذات الصلة عند تفسير اللغة الطبيعية.
تحسين مجموعة البيانات: توحيد الأسئلة والأجوبة والمعاجم التي تم إنشاؤها، وإزالة التضارب الدلالي والصياغات الغامضة، وتصنيف المحتوى حسب المجال المهني، بما في ذلك الجيولوجيا والهندسة والسلامة والإدارة. تخزين البيانات باستخدام تعريفات JSON Schema القياسية للتحميل المباشر عبر واجهات الضبط الدقيق، مما يضمن سهولة الاستخدام والتوافق.
1. نمذجة أنطولوجيا الأعمال خماسية الأبعاد
استنادًا إلى نظرية التنسيق التجاري وتركيزًا على «وحدة الأعمال الدنيا» (MBU)، يصف هذا النهج منطق الأعمال في قطاع النفط والغاز عبر مجالات الكائنات، والأعمال، والأنشطة، والتخصصات، والعمليات التجارية. وتمثل «الأنطولوجيا» بدقة العلاقات المكانية والزمانية والمنطقية بين الكيانات، مما يوفر إطارًا دلاليًا مشتركًا لجميع فئات مجموعات البيانات الثلاث، ويربط البيانات ارتباطًا وثيقًا بالعمليات التجارية.
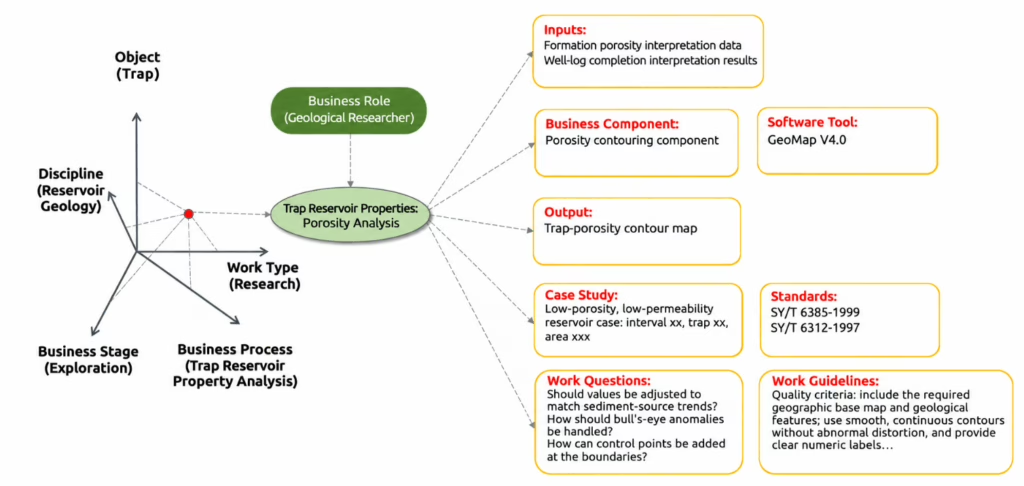
الشكل 2. نمذجة أنطولوجيا الأعمال خماسية الأبعاد
2. تكامل البيانات غير المتجانسة من مصادر متعددة
ادمج أدوات ETL التقليدية مع البنى الحديثة لبحيرات البيانات لإنشاء هياكل وصف وبروتوكولات استيعاب موحدة. تعمل عمليات تحويل التنسيق والتعيين الدلالي والواجهات الموحدة على دمج البيانات المنظمة وغير المنظمة والسلسلات الزمنية والبيانات الحجمية، مما يؤدي إلى كسر الحواجز بين الأقسام.
3. وضع البيانات في سياق الأعمال
تتواجد البيانات الأولية في أشكال عديدة، وتستلزم وضعها في سياق الأعمال أثناء عملية الاستيعاب وبعدها. ويشمل ذلك التقسيم التلقائي للوثائق غير المنظمة إلى وحدات ذات صلة بالأعمال، واستخراج البيانات التجارية، وإنشاء الرسوم البيانية والجداول تلقائيًّا، ومعالجة القياسات الأولية — على سبيل المثال، تحويل العمق المقاس إلى العمق الرأسي الحقيقي. قم بإدارة وتخزين جميع المخرجات الناتجة وفقًا للحد الأدنى من «عقد الأعمال» في الأنطولوجيا الخماسية الأبعاد.
4. التقييم الآلي لجودة البيانات
دمج محركات القواعد والتعلم الآلي في نظام فحص ديناميكي. تعمل القواعد على التحقق من صحة المنطق التجاري، مثل >«ضغط الأنابيب وضغط الغلاف»، بينما تعمل غابات العزل وقاعدة الثلاثة سيغما على تحديد الحالات الشاذة. وتساعد بطاقات تقييم الجودة المقيسة وتوصيات التصحيح في ضمان جودة البيانات الخاضعة للرقابة.
5. دمج «مخطط المعرفة» ومعالجة اللغة الطبيعية
قم بتخزين الرسوم البيانية للمعرفة التجارية في قواعد بيانات الرسوم البيانية مثل Neo4j لإجراء استعلامات معقدة حول العلاقات والاستدلال. قم بدمج أدوات معالجة اللغة الطبيعية (NLP) مثل spaCy وBERT-NER لاستخراج المعرفة من الوثائق، وإنشاء أسئلة وأجوبة، وتوحيد المصطلحات، مما يوفر مدخلات معرفية عالية الجودة من أجل الضبط الدقيق.
6. التخزين الموزع والاسترجاع الفعال
ادمج قواعد بيانات السلاسل الزمنية وقواعد البيانات المتجهة وقواعد البيانات الرسومية. حيث تُخزّن قواعد بيانات السلاسل الزمنية بيانات أجهزة الاستشعار عالية التردد، وتُخزّن قواعد البيانات المتجهة السمات النصية لأغراض البحث عن التشابه، بينما تدعم قواعد البيانات الرسومية استعلامات الرسم البياني المعرفي، مما يتيح التخزين الفعال والاسترجاع السريع.
وقد أدى التحليل والتطوير المنهجي القائم على هذه الأساليب إلى إنتاج خدمات وموارد وأدوات برمجية موحدة تدعم فئات مجموعات البيانات الثلاث جميعها، كما هو موضح أدناه.
1. نتائج التنمية
يغطي نموذج وصف الأعمال خماسي الأبعاد مجالات الاستكشاف والتطوير والإنتاج والتخزين والنقل، مع أدوات صيانة داعمة. ويشمل النموذج ما يزيد عن 40,000 «عقدة أعمال» كحد أدنى، و16,000 مجموعة بيانات قياسية، و150,000 عنصر بيانات قياسي، تغطي المجالات الأساسية للاستكشاف والتطوير والإنتاج. ويمكن للمؤسسات توسيع النموذج بإضافة عقد وعناصر بيانات جديدة. وتدعم الأدوات التحرير المرئي وإدارة الإصدارات وكشف التضارب.
2. القيمة المضافة للعميل
دعم النموذج منصة بحيرة البيانات الخاصة بإحدى شركات النفط الكبرى، مما أدى إلى حل مشكلة عدم اتساق المعايير عبر التخصصات والأنظمة المختلفة. وقد أتمت عملية بناء النموذج، والترحيل، وتكوين مكونات الأعمال، وتكوين الاستعلامات والبحث في الخلفية، مع دعم الاستعلامات متعددة الأبعاد، وعمليات الاسترجاع، والموسوعات التجارية. وتحسنت كفاءة التعاون في مجال البيانات عبر الأقسام بنسبة تزيد عن 60٪، وانخفضت أوقات الاستجابة للاستعلامات من دقائق إلى ثوانٍ.
1. نتائج التنمية
تم إنشاء إطار عمل يشمل الاستيعاب – التنقية – التوحيد – الفحص – الأرشفة – المراقبة، مع أدوات فحص الجودة التي تغطي ست فئات رئيسية و58 فئة فرعية. ويدعم هذا الإطار البيانات المنظمة مثل جداول قواعد البيانات وملفات CSV، والبيانات غير المنظمة مثل الوثائق الفنية والصور الأساسية، والبيانات الزمنية المتسلسلة مثل قراءات أجهزة الاستشعار ومنحنيات الإنتاج. وتدعم أكثر من 2,000 قاعدة فحص خاصة بالصناعة التخصيص، والاستيراد المجمّع، والتنفيذ الآلي، إلى جانب إعداد تقارير الجودة، وتتبع المشكلات، ومتابعة الإجراءات التصحيحية.
2. القيمة المضافة للعميل
وقد تم تطبيق هذا الإطار في ثلاث شركات نفطية كبرى. استخدمت إحدى هذه الشركات الإطار لتنقية واستيعاب 140 مليون سجل استكشافي منظم و2.6 مليون وثيقة نصية وصورية غير منظمة، مما أدى إلى إرساء نظام إدارة فريد ومتسق وكامل وموثوق به لأصول البيانات التاريخية. وأدى نظام إدارة أصول بيانات الاستكشاف الموحد، الذي يرتكز على «بحيرة البيانات»، إلى تقليل دورة فحص الجودة بأكثر من 50%.
1. نتائج التنمية
يضم مستودع الأسئلة والأجوبة القائم على الرسوم البيانية أكثر من 40,000 «عقدة أعمال» و15 نوعًا من الأسئلة، بما في ذلك التعريفات والإجراءات والعلاقة السببية والمقارنات، مع أكثر من 500,000 زوج من الأسئلة والأجوبة عالية الجودة. وتدعم أدوات الإدارة عمليات الإنشاء الجماعي، والمراجعة البشرية، والتصنيف، والأرشفة، وتكرار الإصدارات، والاسترجاع السريع، ومطابقة التشابه الدلالي، والتحديثات التلقائية.
2. القيمة المضافة للعميل
وقد وفرت قاعدة البيانات هذه بيانات أساسية للضبط الدقيق لصالح إحدى شركات النفط، مما أدى إلى رفع دقة الأسئلة والأجوبة المتخصصة من 30% إلى أكثر من 80%. وهي تدعم الأسئلة المتعلقة ببيانات النفط والغاز الفعلية، والتحليل المقارن، والتحليل التشخيصي الآلي. وانخفض متوسط الوقت الذي يستغرقه الموظفون في الحصول على المعرفة المتخصصة من 30 دقيقة إلى أقل من خمس دقائق.
1. نتائج التنمية
تم تجميع المعايير المحلية والدولية، بما في ذلك SY/T وGB وAPI، في مستودع يضم أكثر من 3,000 قاعدة عمل أساسية تغطي مجالات الاستكشاف والتطوير، وسلامة الإنتاج، وحساب الاحتياطيات، وصيانة المعدات. وتقوم الأدوات الذكية باستخراج القواعد تلقائيًا من الوثائق الفنية والمعايير والمعرفة المتخصصة وتحويلها إلى صيغ موحدة. كما تتكامل هذه الأدوات مع أدوات الحوكمة وأنظمة الأعمال من خلال أكثر من 100 واجهة API قياسية.
2. القيمة المضافة للعميل
استخدمت إحدى شركات النفط هذه الموارد لأتمتة عملية إعداد تقارير الحفر وإكمال الآبار والاحتياطيات والتحقق من صحتها، مما أدى إلى تقليص وقت الإعداد من خمسة أيام إلى يوم واحد، وتحسين دقة التحقق بشكل كبير، والقضاء على 80% من الأعمال اليدوية المتكررة. وفي عمليات فحص الامتثال في مجال الإنتاج، قام محرك القواعد بتحديد المخالفات تلقائيًا، مما أدى إلى تحسين كفاءة الكشف عن المخاطر بمقدار ثلاثة أضعاف وتقليل المخاطر المتعلقة بالسلامة.
1. نتائج التنمية
يحتوي الرسم البياني على أكثر من 100,000 كيان و500,000 علاقة، ويغطي أكثر من 20 نوعًا من الكيانات، بما في ذلك الكيانات الجيولوجية، والآبار، والمعدات، والمصائد، والهياكل، و15 نوعًا من العلاقات، مثل «ينتمي إلى»، و«يقع في»، و«يسبب»، و«يحل»، و«يشير إلى». وتدعم منصة إدارته التحرير المرئي، واستعلامات الكيانات والعلاقات، وتحليل المسارات، والاستدلال، والتحديثات الديناميكية، مع التوافق مع بنية خدمات OSDU.
2. القيمة المضافة للعميل
قام مركز معرفي موحد تابع لإحدى شركات النفط بربط البيانات من مصادر متعددة من خلال العلاقات التجارية، مما أدى إلى تحسين كفاءة الاستعلام عن البيانات المرتبطة بنسبة 70%. وقد أتاح ذلك التجميع التلقائي لبيانات تدريب النماذج الصغيرة والتمثيل المنظم لمعرفة النماذج الكبيرة، مما أدى إلى تقليل دورات إعداد بيانات النماذج الصغيرة بنسبة 60% وتحسين الفهم الدلالي للمجال في النماذج الكبيرة بنسبة 50%. كما أدى تحديد البيانات والموارد ذات الصلة باستخدام الرسوم البيانية إلى تحسين التعاون بين الأقسام بشكل كبير.
1. نتائج التنمية
تُعد منصة JuraML أداةً متكاملةً لبناء مجموعات بيانات مخصصة لتدريب النماذج الصغيرة؛ إذ تجمع بين عمليات استيعاب البيانات، واستخراج السمات، ومواءمة مستويات التفاصيل (granularity)، والوسم الآلي، وإنشاء مجموعات البيانات، وتقييم جودتها. وتتضمن المنصة أكثر من 20 خوارزمية متخصصة لاستخراج السمات، وتدعم المواءمة عبر الأبعاد الزمنية والعمقية والطبقية (stratigraphy). كما تتيح تصدير مجموعات بيانات متوافقة مع إطاري العمل TensorFlow وPyTorch، مما يسهّل عمليات بناء النماذج وإعادة استخدامها ونشرها بسرعة وكفاءة.
2. القيمة المضافة للعميل
أتاحت عمليات النشر في حقل للغاز الصخري وحقل نفطي بحري استخلاص ثماني فئات من السمات لاستخدامات متنوعة، تشمل التنبؤ بخصائص المكامن، والتفسير الآلي لبيانات تسجيل الآبار (wireline logs) وسجلات الطين (mud logs)، والإنذار المبكر من حوادث الحفر؛ مما دعم تدريب نماذج صغيرة الحجم مخصصة لـ 15 سيناريو ذكياً. وقد ارتفعت دقة تحديد خصائص المكامن من 30% إلى 70%، بينما انخفض الوقت المستغرق لتفسير سجلات الآبار من ثماني ساعات إلى 40 دقيقة، وهو ما أدى إلى تحسين ملموس في نتائج التطبيق العملي.
تُعد مجموعات البيانات عالية الجودة ركيزةً أساسية للتحول الرقمي والذكي في قطاع النفط والغاز. وتُصنِّف هذه الدراسة مجموعات البيانات بشكل منهجي لتلبية احتياجات ثلاثة مجالات تطبيقية رئيسية، وهي: دعم أنظمة الأعمال، وتدريب النماذج الصغيرة المعتمدة على الذكاء الاصطناعي، وضبط النماذج الضخمة المتخصصة في القطاع؛ كما تقترح الدراسة منهجيات مخصصة لبناء هذه البيانات، وآليات لإدارتها، واستراتيجيات لضمان جودتها.
تشير الأبحاث إلى ضرورة تطوير حوكمة البيانات لتتجاوز مجرد تنظيفها، نحو إدارة دلالية، وموجهة نحو الكائنات، وقائمة على المعرفة. وبالاستناد إلى نمذجة أنطولوجيا الأعمال خماسية الأبعاد، يمكن لتكامل بنية OSDU المفتوحة، ومخازن الميزات، ومخططات المعرفة، وتقنيات توليد الذكاء الاصطناعي، أن يُنشئ نظامًا بيئيًا موحدًا للبيانات يتم تحديثه باستمرار، ومتاحًا للتطبيقات الذكية، مما يوفر مسارًا أساسيًا للتحول الذكي عبر سلسلة قيمة النفط والغاز.
يُعد هذا النهج جوهرياً لإدراك قيمة البيانات وتمكين الذكاء الاصطناعي من تحقيق كامل إمكاناته في قطاع النفط والغاز، الذي يتسم بالتعقيد وارتفاع المخاطر وكثافة رأس المال.
مراجع
[1] الهيئة الوطنية للطاقة في جمهورية الصين الشعبية. SY/T 6025-2012: مواصفات أسماء بنود بيانات احتياطيات النفط والغاز [S]. بكين: دار نشر صناعة النفط، 2012.
[2] باتيدار، إس. (Patidar S.). التحديات والحلول عند اعتماد معيار OSDU في قطاع النفط والغاز [J]. المجلة الدولية لبحوث الإدارة المالية (International Journal of Financial Management Research)، 2023، 11(3): 45–56.
[3] وانغ جيان، لي يانغ، تشانغ لي. دعم اتخاذ القرار الذكي القائم على الرسوم البيانية المعرفية (Knowledge Graphs) لرصد شذوذ استهلاك الطاقة في أنظمة تجميع ونقل النفط وحقن المياه في حقول النفط [مجلة]. مجلة جامعة الصين للبترول (طبعة العلوم الطبيعية)، 2025، 49(2): 121–130.
[4] Dutta S, Roy A, Sen S. استخدام تقنيات الذكاء الاصطناعي/تعلم الآلة لدعم ربط البيانات الزلزالية ببيانات الآبار على منصة OSDU: التنبؤ ببيانات القياسات السلكية (wireline) وبيانات القياسات الزلزالية المرجعية (checkshot) المفقودة [J]. مجلة SPE (SPE Journal)، 2025، 30(2): 897–912.
[5] معهد مهندسي الكهرباء والإلكترونيات (IEEE). المعيار IEEE 3821:2024 الخاص بنظام إدارة البيانات لمحطات خدمات الطاقة الشاملة والذكية رقمياً [S]. نيويورك: رابطة معايير IEEE، 2024.
[6] شركة خدمات تكنولوجيا تسجيل الآبار التابعة لمؤسسة البترول الوطنية الصينية (CNPC) – بناء وتطبيق مجموعات بيانات عالية الجودة لتسجيل الآبار جيوفيزيائياً [تقرير]. شيآن، 2025.
[7] Max180123. Chinese-PetroEngineering-Data-Distill-From-R1 [DB/OL]. مجموعات بيانات Hugging Face، 27-08-2025.
[8] تشن هونغتشي، لين شيوفنغ. تطبيق النماذج اللغوية الكبيرة في حوكمة بيانات الاستكشاف والتطوير [مجلة: تكنولوجيا الحاسوب والتطوير]، 2024، 34(10): 134–139.
[9] وانغ لينا، تشانغ وي، لي تشيانغ. تقنيات التدريب النمطي للذكاء الاصطناعي وتكييف مجموعات البيانات عالية الجودة في قطاع النفط والغاز [مجلة: تكنولوجيا حفر وإنتاج النفط]، 2025، 47(4): 512–520.
روابط سريعة
من نحن